Abeanibot introduced

あべ☆アニ関連でちょっとした Twitter 上のボットを作った:

あべアニ ぼっと
https://twitter.com/Abeanibot

これは AbemaTV 上で新しく配信されるらしいアニメをつぶやく。例えばこんなふうに:

新しくというのは、そのままの意味だ。例えば、すでにのんのんびよりは何度も配信されているので、もしまた再度第 1 話から配信されることになったとしてもそれはツイートされない。一方もし将来まじぽかの配信が決定した場合はそれはツイートされる。

どのように対象の番組を抽出しているか。情報源としては番組表データと、検索結果のデータが考えられるが、今回あべアニぼっとでは検索結果を使用している。というのは番組表データは当日から 1 週間先のものまでしか得られないが、検索であれば更にそれを飛び越えた期間の番組データを得ることができるからだ。

そういうわけでバックエンドでは 1 時間ごとに PHP スクリプトを起動し、AbemaTV の検索 API に対して 2 つのクエリを投げる。なぜ 2 つかというとこの API には若干の癖があるようで、どうも検索結果が 100 件を超えないように調整されるような感じがするのである。AbemaTV のアニメ系チャンネルの場合、タイトルに含まれる話数は必ず [cci]#\d+(〜\d+)?[/cci] の形式になっているようなので、第 1 話から新しく配信されていそうな番組を検索するには [cci]#1[/cci] で検索する。しかしこれには #10 とかも含まれて、直近の番組で 100 件近くに達してしまう。なのでこのクエリだと 1 週間先、2 週間先の新番組を抽出できない可能性がある。

そこで次に、[cci]#1〜[/cci] でも検索する。これなら確実に第 1 話の番組だけを抽出できる。ただしこれの場合複数話連続している配信形態であることが前提になるので、第 1 話を単体で配信するパターンに対応できない。それをカバーするのは最初に投げたクエリである。

この 2 つの検索結果をマージすることで最終的な結果が得られる。ここまで読めば分かるように、この方法だと 1 週間先、2 週間先で、かつ第 1 話を単体で配信するパターンの番組は検索から漏れてしまう可能性があるのだが、まあ仕方がない。クエリに単語区切りを指定するような特別な演算子を含めることができれば解決するのだが、クエリがどのような文法になっているのか分からない。

いずれにしても得た検索結果をローカルに保持してある sqlite のデータベースと照合する。新しいものがあればそれをツイートするという流れだ。

ところで Twitter ボットを作ったのは自由帳ボットに続いて 2 つめなのだが、どちらも純粋にツイートするだけの機能しかない。巷の高機能なボットはフォロー返しや、メンションに対するある程度の反応を行うものもある。これらのボットにもそういう機能が必要だろうか? 要調査。

server status

先週ふたばのみならず、多くのサイトが DDoS 攻撃に晒されサービスを正常に提供できなくなる事件が起きた – 経過。その攻撃自体は今は沈静化している。また、ふたば側ではユーザーとサーバとの間に CloudFlare を挟むようになり、DDoS 耐性が増強された。

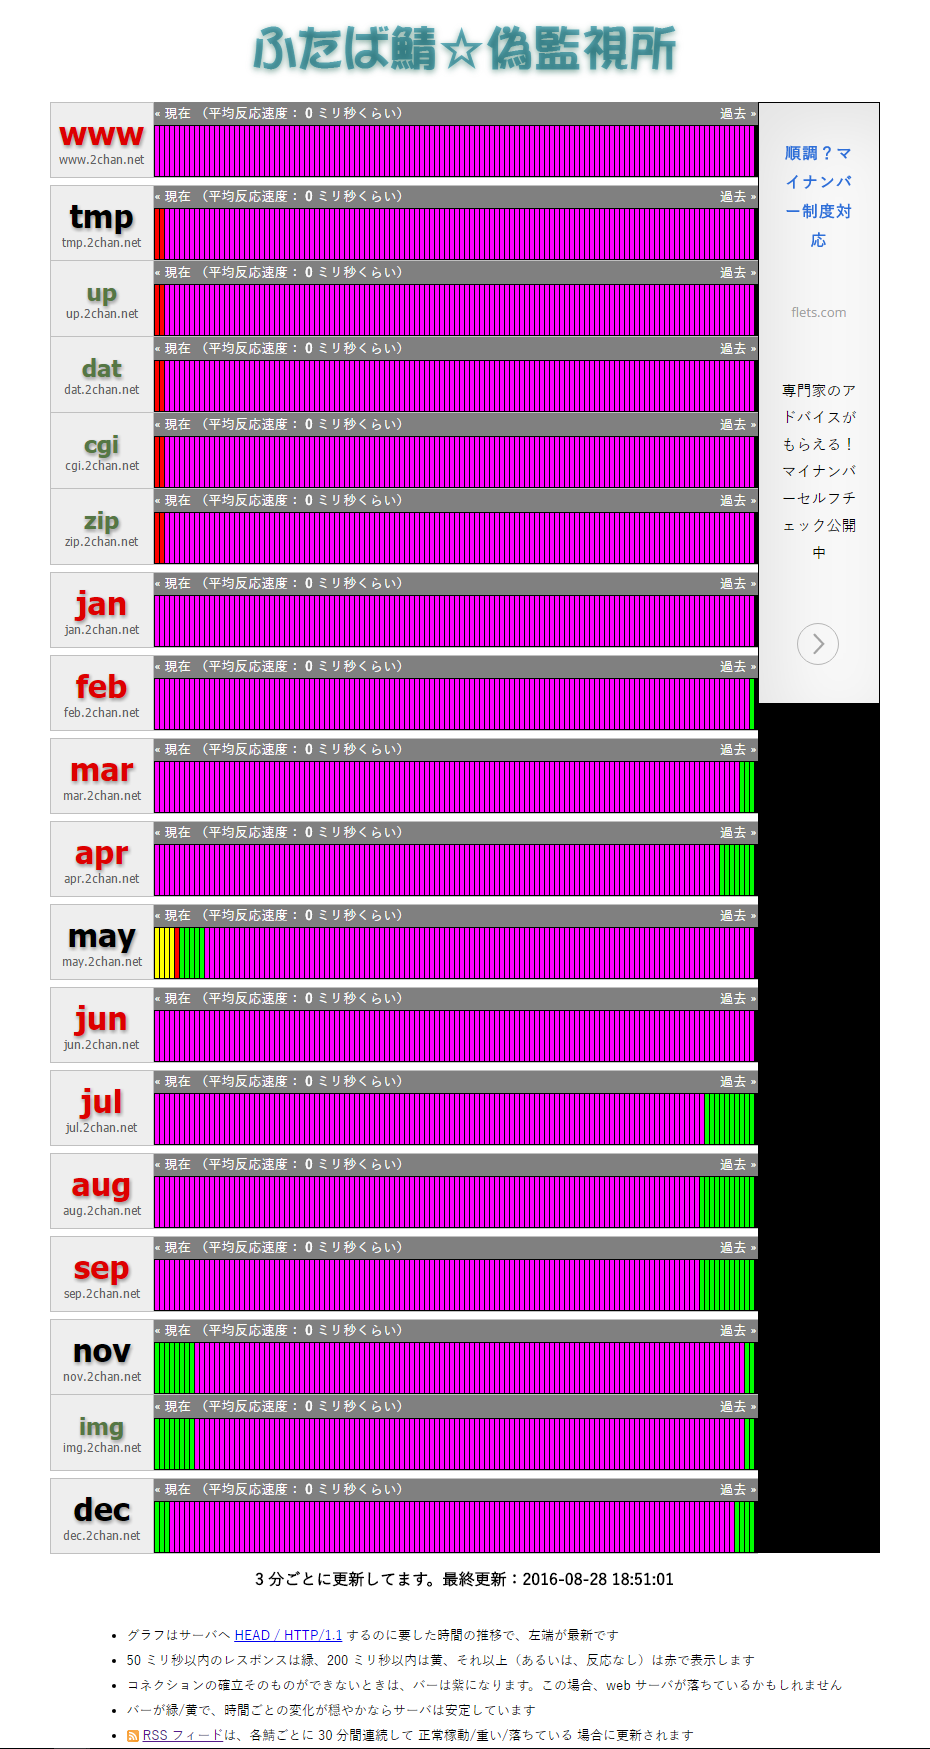
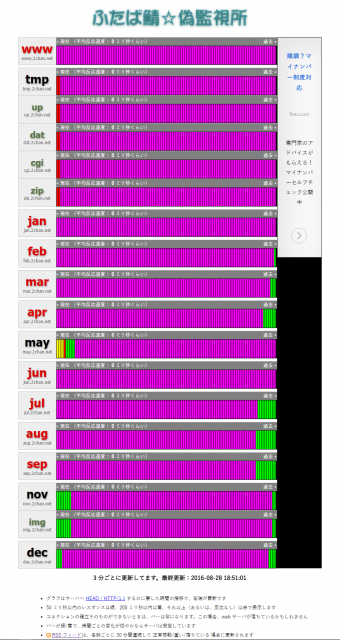
で。ふたばに関してはサーバの状態を観測するには公式の接続テストページか、拙作のふたば鯖☆偽監視所がある。今回はふたばの全サーバが攻撃されたので、公式の接続テストページは本来の役目を果たさない。従ってサーバの状態を確認したいユーザのアクセスが偽監視所に集中し、今まではだいたい日に 100 件とかそこらのアクセスだったのが、400000 アクセスとかに増えるようになった日が数日続いた。

偽監視所にアクセスして返される内容は gzip された静的な html であり、内容に含まれるグラフっぽい何かはすべて CSS で表現される軽量なテキストデータなので、サイズは高々 10 KB 程度だ。それでも、400000 アクセスされると一日の転送量は 3GB くらいになる。3GB というのは xrea の一日の転送量リミットの上限の数値だ(ただ、これが絶対の上限だと明言されているわけではない。これを超えると何がどうなると明言されてるわけでもない。このゆるゆるでテキトーでいい加減な管理ポリシーが今となっては xrea の最大の魅力だ)。従っていますぐ xrea を追い出されるということではないのだが、もしも転送量が倍々ゲームになるようだといろいろと対策を考えないといけない。

というわけでいろいろ改修を施した:

  • PHP のバージョンが上がることによって発生していた warning を潰した。これらはクラスのインスタンスを保持するのに [cci]=&[/cci] を使っていたとか、クラスのメソッドを static に呼び出していたという、PHP4 からの移行期の遺物だった。なにしろ偽監視所を作ったのは 2010 年のことでその後ずっとほったらかしのまま稼働させていたので仕方がない
  • 従来の仕様では、同じ IP アドレスを持つ複数の仮想名を持つサーバに関しては最初の 1 つだけ HEAD を飛ばし、それを残りのサーバにも適用していた。しかし今回 CloudFlare を挟むようになったことですべてのサーバが見かけ上同一の IP アドレスを共有するようになったので、HEAD は律儀に個別に飛ばすようにした
  • 従来の仕様では、サーバ名から IP アドレスを正引きのは単に [cci]gethostbyname()[/cci] していた。今回やはり CloudFlare を挟むようになったことで、複数の CloudFlare 側のアドレスが割り当てられるようになり、単に [cci]gethostbyname()[/cci] を呼ぶだけではラウンドロビンにより呼び出しの度異なるアドレスが返されるようになった。そこで [cci]gethostbynamel()[/cci] を使うようにし、ソートした上で先頭の IP アドレスを使うようにした
  • ユーザに返す html は 3 分ごとにリロードするようにしていたが、5 分 15 秒ごとにした

もうひとつ重要な心残りがある。偽監視所のグラフはいわば時系列を示している。しかし一般的な時系列グラフが、右端が最新を示すのに対して偽監視所は全くその逆で左端が最新なのである。6 年前の自分がなぜそういう仕様にしたのかこれっぽっちも全く覚えちゃいないのだが、今回見なおしたらやたら気になった。そこで虹裏に適当なスレが立った時に「」に聞いてみたところ、慣れたのでこれでいいという言質がとれた。これはつまり、これ以降「このグラフの仕様変じゃね?」という意見が出たとしても「」の総意ですからということでおあしすできるということだ…!

Enable mecab on xrea server

ぼちぼちあべ☆アニに検索機能を追加したい。この機能は:

  • 当日から1週間先までの範囲内で
  • タイトル、説明に含まれる任意の文字列を全文検索する

という仕様にしておこう。まずサーバ側で必要なものを考えるととりあえずは全文検索機能を備えたデータベースだ。以前タテログを作った時は MySQL を使った。しかし xrea サーバ上の MySQL というのは、当然だがルートユーザの権限が必要なチューニングは一切できないのがネックだ(実は裏技がなくもないのだが、それをここでは公開できない)。タテログの場合も全文検索用のメモリの割り当てをもうちょっと増やしたいのだが、いかんともしがたい。そういう訳で今回は SQLite を使ってみたい。

次に必要なのは、日本語を形態素解析するライブラリだ。タテログの場合は大掛かりな機構を使わず、2-gram で済ませたのだがやはりこのへんはきっちりやりたい。フリーの形態素解析器といえばなんといっても Mecab とか Chasen とかだ。これらを xrea 上で使えると嬉しい。さらに欲を言えば、これらを子プロセスとして呼び出すのではなく PHP エクステンションとして扱えるとなお良い。その場合のバインディングは php-mecab を使うことになる。

さて、実は xrea サーバにはすでに mecab はインストールされている。ただし、バージョンは 0.93 と若干古い。また、PHP バインディングは用意されていない。なので今回はこれは使わず、自前で mecab と php-mecab を xrea サーバ上でビルドすることにしよう。幸い xrea サーバには ssh でログインでき、また gcc 等々のビルド環境及び PHP エクステンションをビルドするための phpize ツールなどもあらかじめインストールされている。

Mecab と辞書のビルド

  • 作業用ディレクトリを予め掘っておく。今回は ~/devel (/virtual/akahuku/devel) とした
  • Mecab 公式からソースを落としてくる

  • $ tar zxf mecab-0.996.tar.gz
    $ cd mecab-0.996
    $ ./configure --prefix=$HOME --enable-utf8-only --with-charset=utf8
    $ make
    $ make check
    $ make install
  • 同様に辞書を落としてくる: とりあえず今回は IPA 辞書を落とした

  • $ tar zxf mecab-ipadic-2.7.0-20070801.tar.gz
    $ cd mecab-ipadic-2.7.0-20070801
    $ ./configure --prefix=$HOME --with-mecab-config=/virtual/akahuku/bin/mecab-config --with-charset=utf8
    $ make
    $ make install

php-mecab のビルド
PHP エクステンションをビルドするには、前述の phpize を使う。これ自体はちょっとしたシェルスクリプトで、php のインクルードファイル等々を走査しつつ configure スクリプトを生成する。ここで困ったことが 1 つある。xrea のサーバは複数のバージョンの PHP が同時にインストールされていて、コントロールパネルからどれを使用するか選択できるのだが、どれを選択しても /usr/local/include/php 以下の内容は最も古い php5.3 のもののままなのである。従って他のバージョンの PHP 向けに普通に make すると php 本体とエクステンションのバージョン不整合が起こり認識されない。ちなみに appsweets.net で使用している PHP は 5.5.35 だ。そこで:

  • PHP 公式から該当 PHP のソースを落として、展開して、configure *だけ* やっておく
  • php-mecab のソースディレクトリ(今回は /virtual/akahuku/devel/php-mecab/mecab/)で

    $ php55ize
    $ ./configure --prefix=$HOME --php-config=/usr/bin/php55-config --with-mecab=/virtual/akahuku/bin/mecab-config
  • 生成された Makefile を vi で開き、/usr/local/include/php を含んでいるマクロの該当部分をすべて自前の PHP のソースディレクトリ(今回は /virtual/akahuku/devel/php-5.5.35)に置き換える

  • $ make
    $ make test
  • make install はしない(というか権限の関係上できない)。modules ディレクトリに出力された mecab.so をそのまま使う

PHP への組み込み
xrea の場合、現在は PHP を各ユーザの ~/.fast-cgi-bin 以下の php.ini 及び起動スクリプトによって起動させている。php55.ini を vi で開き

extension="/virtual/akahuku/devel/php-mecab/mecab/modules/mecab.so"
mecab.default_dicdir="/virtual/akahuku/lib/mecab/dic/ipadic"

を追記。

あとは fcgi による php が再生成された時に phpinfo(); して mecab が組み込まれていることを確認。

* * *

という感じになる。これにより、

$mecab = new MeCab_Tagger("すもももももももものうち");
echo $mecab->parse($str);

というように PHP から直接 Mecab の機能を使えるようになる。ここで更にもうひとひねりある。PHP の SQLite には面白い機能がある。SQLite3#createFunction() で SQL のクエリ内で使用できる関数を PHP の関数で自由に定義できるのである。つまり、PHP 側で

function php_tokenize ($arg) {
return (new Mecab_Tagger(["-O" => "wakati"]))->parse($arg);
}
$db = new SQLite3("foo.sqlite");
$db->createFunction("tokenize", "php_tokenize");

などとすると、クエリで直接

insert into table (content, tokens) values ("すもももももももものうち", tokenize("すもももももももものうち"));

などと書ける。これは面白い。データベースが PHP と同じプロセスで動いているからできる芸当だ。文字列のマーシャリングとか問題ないのか若干心配がないこともないが…。

ところで createFunction()、createAggregate()、createCollation() を使う際には第一に気をつけるべきことがある。もしその PHP 側のコールバック関数内で例外が発生して PHP の実行が中断された場合、SQLite 側のトランザクションは正しくロールバックされず、ジャーナルファイルが作られたまま、そしてデータベースファイル自身はロックされたまんま(ロック元は、mod_php 環境であれば http サーバだ。fcgi 環境では知らない)になってしまう。つまりコールバック関数内では出来うる限りガチガチにエラーチェックする必要があるということだ。

などとさっきまでやっていたら、いつの間にかふたばが全滅していた。
serverstat
なにこの…なに?

ramen

ひところステマが話題になったが、この記事もまた徹頭徹尾ステマである。

NTT のフレッツ光を契約していた頃の話なのだが、この契約は月ごとにいくばくかのなんちゃらポイントが与えられるシステムになっていた。貯まったポイントに応じていろいろな景品と交換できるというまあありがちなものだ。そして、景品の中で上等なもの(例えば iPad とか)は、「まあ10万年くらいフレッツ光に契約し続ければそれくらいのポイントが貯まるかもね…」というような無茶な設定になっている点も非常にありがちであった。

もちろんそんなに待ってられないので、解約する直前で使っちゃったのだが:

ramen-2

ramen-1

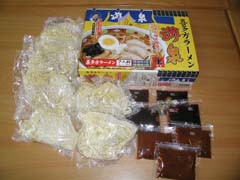
使ったというのはつまりこのラーメンだ。これがとても美味しかった。1 杯分の単価で考えるとそのへんで売ってる袋麺の 2 倍くらいになると思うが、10 倍美味しいので全く問題ない。

このセットは web から注文できる:

喜多方ラーメン游泉三浦屋 醤油・味噌7食入り
http://shop.fm-kitakata.co.jp/shop/shopdetail.html?brandcode=000000000849

Ubuntu 16.04

Ubuntu 16.04.1 LTS (Xenial Xerus) がリリースされうちのマシン(Xubuntu)にもアップグレード通知が来たのだが、困ったことがある。

現状 AMD 製 GPU の Linux 向けドライバには 3つの選択肢があり:

  • Radeon ドライバ: OSS で、あんまりハードウェアの性能は引き出せない。多分安定はしている
  • fglrx ドライバ: AMD 製のプロプラ。まあまあ性能を引き出してるのだと思うけど(あと設定が Catalyst による GUI で行えるので試行錯誤しやすい)、あんまり安定してない
  • amdgpu ドライバ: 最新の Linux カーネルの管理下にある OSS ドライバだが、AMD からの技術公開を受けて安定さと性能を両立している(という触れ込み)だが超ナウい GPU しか今のところサポートしていない

うちのマシンは GPU が AMD Radon HD 6320 というやつなのだけど、困ったことに AMD は 16.04 向けの fglrx を作らない宣言を出しているのであった。なので、今 16.04 にアップグレードすると Radeon ドライバか amdgpu ドライバを選択せざるを得ないのだけど、amdgpu は今のところ HD 6320 をサポートしていないので対象外(最終的にはもっと古い GPU もサポートすると言っているのだがいつかは不明)。そういうわけで Radeon ドライバが最終候補になるのだが。前述のとおりこれは OSS 原理主義者のためのものであって性能はいまいちなのである。

というわけで、16.04 にアップグレードしたくてもできない。はやく amdgpu が進歩してほしい。

The TV program time table #2

CloudFlare 絡みでもうひとつ。オリジンサーバから送出される静的なコンテンツについて、CloudFlare は CDN として振る舞う。つまり CloudFlare 側でキャッシュし、クライアントのアクセスの際はそのキャッシュを利用すると同時にオリジンサーバの負荷を低減する。

この静的の定義とはなんぞやというと、このへんに詳しい。特定の拡張子を持つもの、Cache-Control ヘッダで public と指定されかつ max-age が 0 より大きいもの、PageRule で特別に指定されたもの…という感じ。意外なことに html ファイル自体はキャッシュされない(PageRule の設定でキャッシュさせるようにすることはできる)。

で。あべアニのうち最もファイルサイズがでかいのは、番組表のデータである json ファイルなのであるが(gzip して 200KB 弱くらい)、アクセス解析を見てみたらなんとこれが CloudFlare 側にキャッシュされていないのであった。これはいけません。

とりあえず適切に Cache-Control ヘッダを付加するようにしてみたところ、効果なし。そこで mod_rewrite で擬似的な js ファイルとして扱うようにして、かつクエリ文字列を使わないようにしてみたところ、キャッシュに乗るようになった。間抜けなことにそれらを同時に変更したので、乗るようになった要因が拡張子なのかクエリ文字列なのかはっきりしていないのだが、まあ結果オーライなのだ。

ちなみに PageRule で何とかする方法もあるのだが、フリープランだと何と登録できる PageRule は 3 つまでなのである。ダイヤモンドより貴重なのでホイホイ使うわけにはいかない。

CloudFlare のキャッシュに乗っているかどうかは、レスポンスヘッダに [cci]cf-cache-status: HIT[/cci] が含まれているかどうかで判断できる。また、CloudFlare に限らずコンテンツが CDN によって適切に分散されているかどうかは https://www.webpagetest.org/ でテストすることができる。

The TV program time table

Abema.tv というサービスがある。これはつまりインターネット上の無料 TV サービスである。様々なチャンネルを持っているのだが、その中に 5 つくらいアニメ専門チャンネルがあり、そのせいで(あるいはそのおかげで)虹裏 img はここのところ半分 Abema 実況板と化している状態だ。

というわけで見てみたところ、Abema のサービス自体は非常によく出来ているのだが、ただひとつ番組表が使いにくいと感じた。全体的に重いのと、1 ページに 5 チャンネル分の番組表が表示されるのだがこれが単純にチャンネル番号順で、カテゴリ分けされるわけではない。そのため例えばアニメだけで一覧、ということができない。また、ページを非アクティブ状態からアクティブにした瞬間、どうも現在時刻に合わせた番組枠を表示しようとスクロール位置を変えるっぽいのだが、それがバグってるっぽい上になかなか直らない。……などなど、いろいろと不満があるのである。

そういうわけで、代替物を作った:

あべ☆アニ
https://appsweets.net/abeani/

これを作る過程での技術的なポイントはなくもないのだが、本質的にはただの html と javascript だけのシンプルなページであり、特に書くほどのものではない。

しかしこの番組表自体には直接関係ない分野から強いて 1 つ書いておくとすると、CloudFlare のキャッシュとの連携が挙げられる。知ってのとおり CloudFlare は静的ファイルをキャッシュする。従って web ページを開発して頻繁にサーバにアップロードして動作確認をする際はそのキャッシュ機構が邪魔になる。そんなわけで CloudFlare のサイトにログインすると現れるダッシュボードには個別のファイルのキャッシュをパージする機能が用意されているのだが、もちろん手作業になるのでめんどくさい。

と、だれでもそう思うわけで、API が用意されている。で結局、rsync した結果を元に API を呼び出すスクリプトを書いて解決。

Talk about news #2

PhoneticNews は一種の RSS リーダーと考えることができるが(ただし NHK ニュースに関しては公式サイトが内部的に利用している、限りなく RSS に近い独自形式の XML を利用している)、任意のアドレスのフィードを利用できるわけではないので用途はかなり限定的だ。

なぜフィードを絞っているのかというと、発話の際のトラフィックの問題だ。PhoneticNews は発話データを得るのに VoiceText の API を利用している。この API のエンドポイントに文字列を POST すると、それを読み上げた発話の aac データが返ってくる。

この VoiceText へのネットワークアクセスは PhoneticNews をインストールした Chrome がそれぞれ個別に行うため、任意のフィードを登録できるようにすると VoiceText 側の負荷が結構なものになるかもしれないのである。まあ、勝手な想像なのですが。

API のリファレンスには呼び出しに関する回数や頻度の制限などは記述されていないので、どこまで許されるのか実際わからないのであった。うーんお問合せしたほうがいいのかなー。

いずれにしてもできうることを考えると、

  • 各 Chrome から個別に VoiceText にアクセスさせることをやめて、ここのサーバを経由させる。ここのサーバが代理的に VoiceText へのやり取りを行う: ここのサーバへの負荷はどうするのかという話になるが、現状でここのサーバは CloudFlare のお世話になっているのでたぶん負荷の面では大丈夫
  • 発話データを Chrome 自身の tts で生成する: ただし、日本語の発話データは OSX か、Windows10 以降じゃないと取得できない、らしい

あたりになると思う。はてさて。

Talk about news

PhoneticNews という Chrome エクステンションを前書いたのだが、いくつか既知のバグがあり、特に Chrome の起動時に二重に読み上げが行われる現象がある。この機会に探ってみた。

このエクステンションは定期的に NHK のニュースを読み込み、それを読み上げる。そのためにバックグラウンドで定期的に読み込み処理、読み上げ処理を走らせることが動作の核になる。一般的にそれを実現するには setTimeout や setInterval を使うのだが、Chrome のエクステンションの場合はバックグラウンドページの構造について Event Pages という別のアプローチがあり、PhoneticNews もそれを使っている。しかしこれがなかなかに癖があり、正しくそれに対応していなかったのがバグの原因になっている。

エクステンションのバックグラウンドが Event Pages のルールに従うか否かで変わる最大の物は、つまりバックグラウンドページが勝手にアンロードされるか否かということだ。バックグラウンドがアイドル状態になると即アンロードされる。アンロードというのは Chrome ブラウザの環境下においては、エクステンションに割り当てられたプロセスを終了するという意味だ。つまり Event Pages に対応すると、タスクマネージャを開いた時ずらっと Chrome が並ぶのを幾ばくか減らすことができるというわけだ。これはもちろんその分のメモリを開放するという意味もあるが、特にモバイル機器において不要な負荷を減らしバッテリーの寿命を伸ばすという効果があるのだと思う。

さて Event Pages では setTimeout/setInterval の代わりに chrome.alarms を使う。これにアラームを登録すると指定したタイミングにバックグラウンドがロードされ、次に chrome.runtime.onStartup に登録したイベントハンドラが呼ばれ、最後にアラームに登録したイベントハンドラが呼ばれる。

このアラームが特徴的なのは、登録が Chrome ブラウザに対して永続的であるということだ。定期的に発生するアラームは、エクステンションのインストール時にただ 1 度登録すればいいのである。PhoneticNews ではそれを知らず、アラームの登録をエクステンションのスタートアップ時に毎回行っていた。これが起動時に二重に読み上げが行われていた原因だ。

その他、従来は NHK ニュースだけに限っていたのを他のニュース配信社もいくつか含めるようにした。
phoneticnews-options
これ以外に、例えば共同通信や時事通信あたりも入れようかなと思ったのだが、なぜか日本の配信社は RSS フィードを公開していない、あるいはこっそりとしか公開していないところが多い。

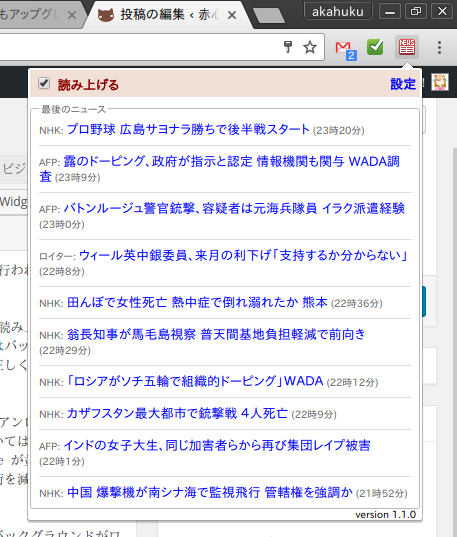
アイコン押下時のポップアップでは最後に読み込んだ 1 件のニュースだけを表示していたのだが、最大 10 件にまで拡大した。
phoneticnews-popup

fixed: GRADIUS

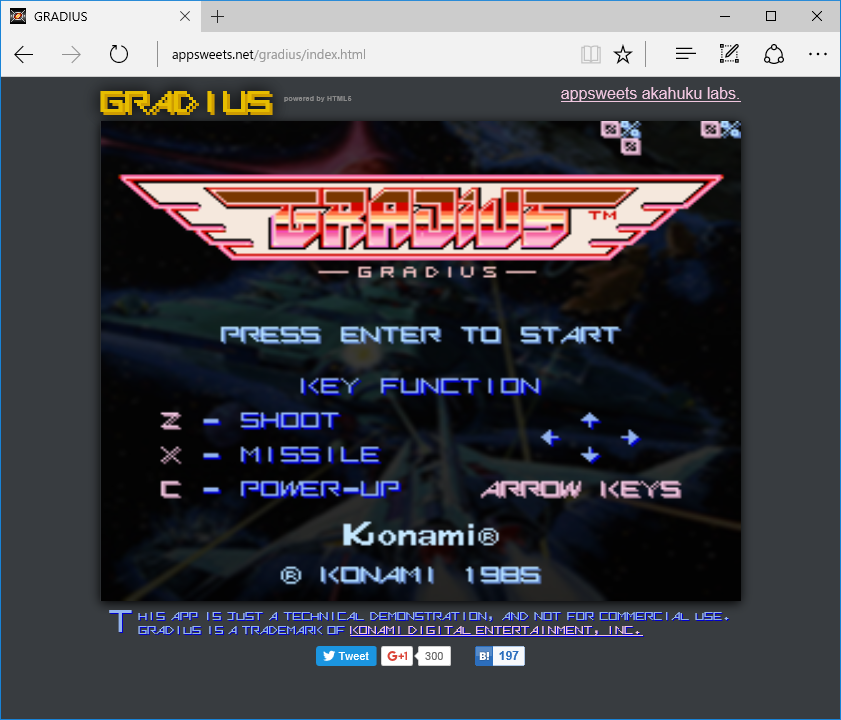
gradius-on-edge

手持ちのプロジェクトをいろいろ整理しているのだが、ずいぶん前に作ったグラディウスのソースを読んでたら RequestAnimationFrame の使い方を勘違いしたまま数年経過してたようなのでとりあえず直してみた。若干スクロールがスムーズになった気のせいがするかもしれない以外は特に動作は変わっていない。というよりも、各種データをどこからどうやって生成したのかきれいさっぱり忘れているのでソースを近視眼的にいじるくらいしかもうできないのだが。

その他、Windows 10 の edge で動かないという話があったので


edge でも動作するよう確認。

edge 自身は…将来に期待という感じ。今夏の Windows 10 のアップデートで拡張機能の実装を含めて良くなるそうなので、そのときになったら wasavi のテストもしてみたい。